MeshXFS, CetraFS
Indice navigabile
Quella meravigliosa anarchia chiamata Open Source.
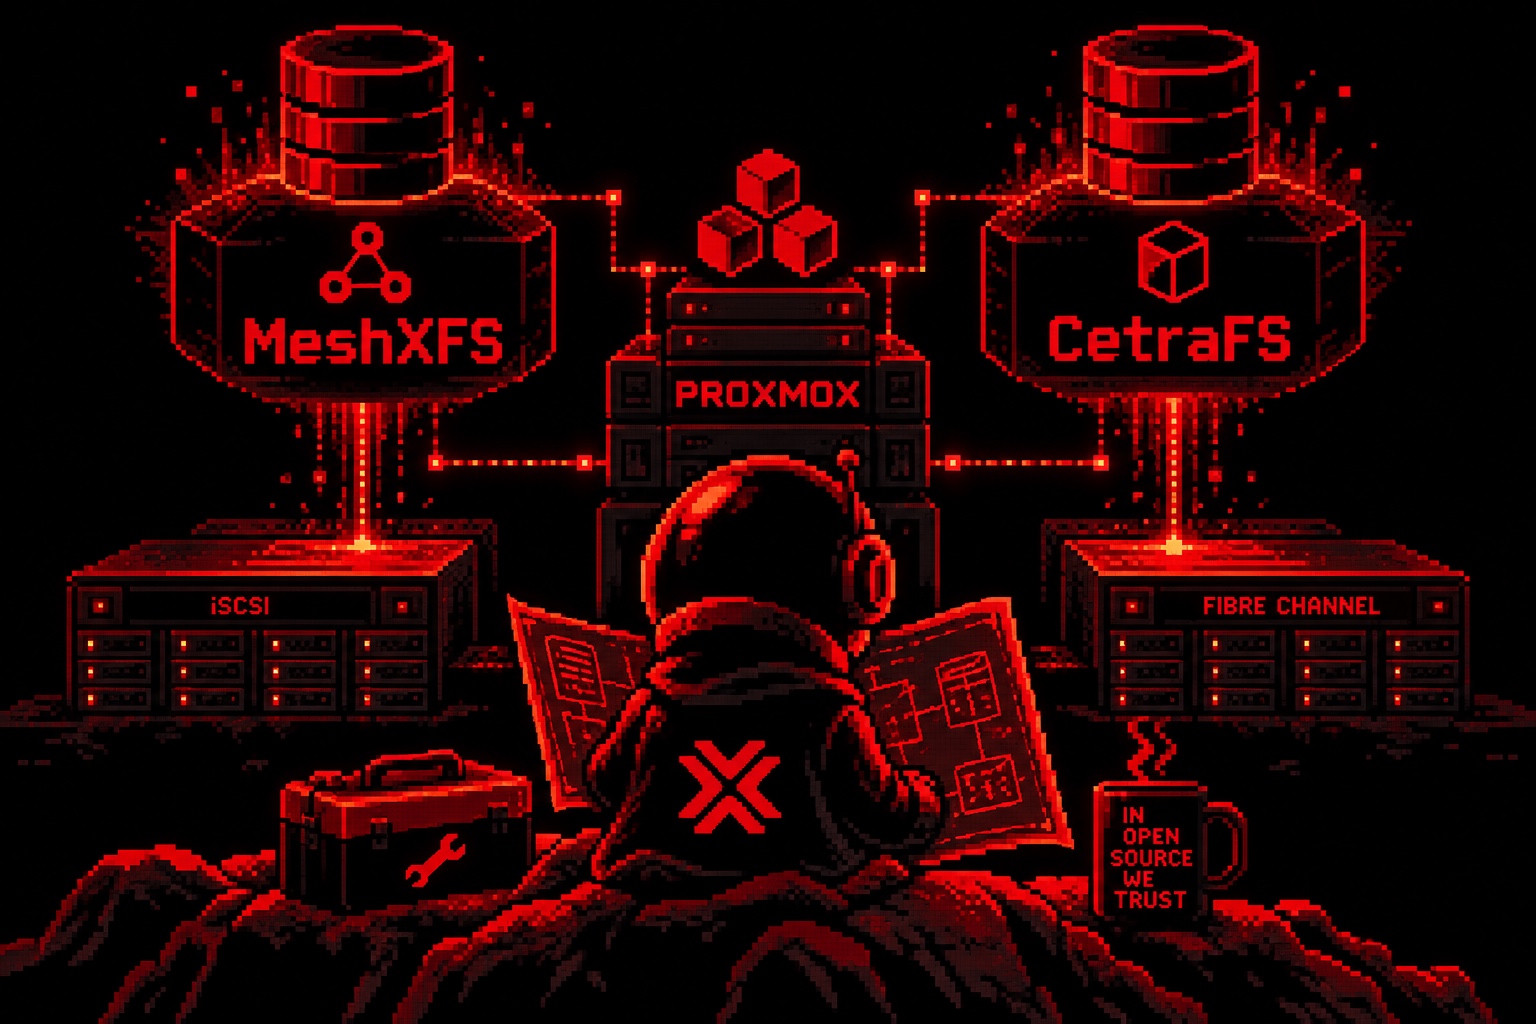
Due filesystem, una ricerca su Proxmox e la dimostrazione che il vero potere del software libero non è soltanto usarlo. È poterlo reinventare.
Tutto è cominciato con una domanda abbastanza semplice
Chi mi conosce sa che ho un rapporto piuttosto particolare con le infrastrutture informatiche.
Quando qualcosa funziona, sono contento.
Quando qualcosa funziona, ma potrebbe funzionare diversamente, comincio a farmi domande.
E quando comincio a farmi domande, generalmente finisco per perdere qualche ora tra documentazione, repository GitHub, forum tecnici e progetti che probabilmente non dovrei nemmeno guardare.
Questa volta il colpevole è Proxmox.
O meglio, lo storage condiviso di Proxmox.
Stavo facendo alcune ricerche per individuare soluzioni alternative a Ceph, possibilmente open source, che permettessero di gestire uno storage condiviso tra più nodi di un cluster.
Perché Ceph è fantastico, sia chiaro.
È potente, distribuito, resiliente e, quando progettato correttamente, permette di costruire infrastrutture di storage davvero interessanti.
Ma Ceph non è necessariamente la risposta a ogni domanda.
E soprattutto non è detto che, per ogni infrastruttura, serva tirare in piedi un intero ecosistema di OSD, MON, MGR, reti dedicate, replica distribuita e tutto quello che ne consegue.
A volte hai già una SAN.
A volte hai dei nodi con storage locale e vuoi sfruttare DRBD.
A volte vuoi semplicemente utilizzare meglio l’hardware che possiedi.
E a volte, diciamocelo, vuoi evitare di costruire una portaerei per attraversare il laghetto del parco.
Così ho iniziato a cercare.
E mi sono imbattuto in due progetti che, indipendentemente dal loro futuro, rappresentano qualcosa che amo profondamente del mondo open source.
MeshXFS e CetraFS.
Il problema che cercano di risolvere
Partiamo da un concetto fondamentale.
In un cluster di virtualizzazione, poter accedere allo stesso storage da più nodi è estremamente utile.
Significa poter spostare macchine virtuali tra host, gestire scenari di alta disponibilità e sfruttare infrastrutture SAN condivise senza dover necessariamente copiare i dischi da una parte all’altra.
Chi ha lavorato con VMware conosce VMFS, il filesystem progettato per consentire a più host ESXi di utilizzare contemporaneamente lo stesso datastore.
Nel mondo Linux esistono diverse tecnologie per affrontare problemi analoghi.
GFS2, OCFS2, LVM condiviso, DRBD, Ceph e altre ancora.
Non sono tutte equivalenti, naturalmente.
Alcune sono filesystem clusterizzati, altre gestiscono dispositivi a blocchi, altre ancora implementano direttamente la distribuzione e la replica dei dati.
E questa distinzione è importante.
Perché storage condiviso e storage distribuito non sono sinonimi.
Nel primo caso più nodi accedono a una risorsa comune. Nel secondo, generalmente, i dati vengono distribuiti e spesso replicati su più sistemi.
Ceph appartiene a questa seconda famiglia.
MeshXFS e CetraFS, invece, puntano principalmente a risolvere un problema differente: consentire l’accesso concorrente e sicuro a un filesystem ospitato su storage a blocchi condiviso.
Non sono quindi sostituti universali di Ceph.
Ma potrebbero diventare alternative interessanti in determinati scenari.
E già questo sarebbe un bel risultato.
MeshXFS: prendiamo XFS e facciamogli fare qualcosa per cui non era nato
Il primo progetto che ha attirato la mia attenzione è MeshXFS.
L’idea è tanto semplice da raccontare quanto maledettamente complicata da realizzare.
Prendere XFS, un filesystem Linux consolidato, e aggiungere i meccanismi necessari per consentire a più sistemi di montarlo contemporaneamente in lettura e scrittura.
Chiunque abbia un minimo di esperienza con i filesystem sa che montare lo stesso XFS tradizionale in scrittura su più host è un modo piuttosto creativo per trasformare i propri dati in coriandoli.
Servono meccanismi di coordinamento.
Servono lock distribuiti, gestione coerente delle cache, fencing e procedure di recupero dopo un guasto.
E soprattutto serve garantire che due nodi non decidano contemporaneamente di essere gli unici proprietari della verità.
MeshXFS prova a fare proprio questo.
Il progetto, portato avanti da Stephen Shoecraft, prevede l’utilizzo di storage SAN iSCSI condiviso e contempla anche configurazioni basate su DRBD dual-primary.
È presente persino un plugin per l’integrazione con Proxmox VE.
Ma c’è un dettaglio che rende tutta la vicenda ancora più interessante.
Il codice che introduce le funzionalità clusterizzate è stato sviluppato utilizzando agenti di intelligenza artificiale.
Sì, avete letto bene.
Non stiamo parlando di chiedere a un chatbot di scrivere uno script Bash per riavviare un servizio.
Stiamo parlando di codice a livello kernel, gestione della concorrenza, locking e recupero dopo guasti.
Tutta roba dove un errore non produce semplicemente un messaggio rosso sul terminale.
Può produrre una perdita di dati.
Naturalmente, il fatto che il codice sia stato generato con l’AI non lo rende automaticamente buono, cattivo, affidabile o pericoloso.
La qualità va dimostrata con test, revisione, analisi e utilizzo reale.
E personalmente non affiderei oggi un datastore di produzione a MeshXFS.
Ma il punto è un altro.
Qualcuno ha avuto un’idea.
Ha preso una base software esistente, ha deciso di modificarla e ha pubblicato il risultato affinché altri possano studiarlo, provarlo, criticarlo e migliorarlo.
Questo è già straordinariamente interessante.
CetraFS: stesso problema, strada differente
Mentre approfondivo MeshXFS, mi sono imbattuto in CetraFS.
Altro progetto open source.
Altro filesystem clusterizzato.
Altro tentativo di portare nel mondo Proxmox un’esperienza di storage condiviso simile a quella offerta da VMFS.
Ma con un approccio differente.
CetraFS nasce come filesystem dedicato allo storage condiviso delle macchine virtuali, utilizzando operazioni atomiche SCSI per coordinare gli accessi dei diversi nodi.
L’obiettivo è consentire a più host Proxmox di utilizzare contemporaneamente la stessa LUN iSCSI o Fibre Channel.
Il suo sviluppatore racconta di essere partito da un’esigenza molto concreta: continuare a utilizzare un’infrastruttura storage già acquistata, senza rimanere prigioniero delle scelte commerciali del fornitore dell’hypervisor.
Vi suona familiare?
Hai comprato l’hardware.
L’hardware funziona.
Poi qualcuno decide che, per continuare a utilizzarlo come prima, dovresti rivedere il budget IT, accendere un mutuo e possibilmente ringraziarlo per l’opportunità.
Ecco.
CetraFS nasce anche come risposta a questo genere di situazioni.
Il progetto è ancora in fase beta e richiede verifiche approfondite prima di poter essere considerato per ambienti critici.
Ma anche qui il punto interessante non è soltanto la tecnologia.
È la motivazione.
Una persona aveva un problema.
Non trovava una soluzione soddisfacente.
E ha deciso di costruirsela.
E poi succede una cosa bellissima
La parte che mi ha fatto sorridere maggiormente è arrivata leggendo le discussioni della comunità Proxmox.
I due sviluppatori si sono incontrati sul forum.
Uno aveva sviluppato MeshXFS.
L’altro CetraFS.
Due progetti indipendenti, con obiettivi molto simili, comparsi pubblicamente praticamente nello stesso periodo.
E sapete cosa è successo?
Si sono complimentati.
Hanno manifestato interesse per il lavoro dell’altro.
E si sono proposti di provare reciprocamente i rispettivi filesystem.
Fine.
Nessuna guerra di religione.
Nessuna conferenza stampa per spiegare che l’altro progetto è tecnicamente inferiore.
Nessun reparto marketing impegnato a inventarsi un acronimo di sette lettere per descrivere una funzionalità che esiste da vent’anni.
Solo due persone che hanno affrontato un problema simile e sono curiose di vedere come l’altro abbia deciso di risolverlo.
Non so voi, ma io trovo questa cosa meravigliosa.
Il fork non è una bestemmia. È una delle fondamenta dell’open source.
Ed eccoci al motivo per cui ho deciso di scrivere questo articolo.
Perché MeshXFS e CetraFS sono interessanti, certo.
Ma rappresentano soprattutto un’occasione per ricordare qualcosa che troppo spesso viene dimenticato.
Il software open source non è semplicemente software che puoi utilizzare gratuitamente.
Quella è una conseguenza possibile, non la sua essenza.
Il vero valore è la libertà.
La libertà di studiare come funziona un programma.
La libertà di modificarlo.
La libertà di adattarlo alle proprie esigenze.
La libertà di redistribuire le modifiche, nel rispetto delle licenze applicabili.
E, quando serve, la libertà di prendere una strada completamente diversa.
Il fork è una delle espressioni più concrete di questa libertà.
Non deve necessariamente essere una dichiarazione di guerra contro il progetto originale.
Può essere un esperimento.
Può essere una necessità.
Può essere il tentativo di risolvere un problema che gli sviluppatori originali non hanno interesse ad affrontare.
Può perfino essere un errore.
E va benissimo anche quello.
Perché non tutte le idee devono diventare prodotti commerciali, conquistare il mercato o trasformarsi nella prossima fondazione internazionale con ventisette sponsor Platinum.
Alcune idee servono semplicemente a esplorare nuove possibilità.
MeshXFS parte da XFS e tenta di portarlo in un territorio diverso.
CetraFS affronta un problema analogo costruendo una propria soluzione.
Due strade.
Due approcci.
Due esperimenti.
E nessuno ha dovuto chiedere il permesso a un consiglio di amministrazione per iniziare.
Non è tutto rose e fiori, naturalmente
Prima che qualcuno decida di installare entrambi i filesystem sul cluster di produzione lunedì mattina, facciamo una precisazione.
Stiamo parlando di progetti giovani.
Interessanti, promettenti, ma giovani.
E lo storage non è esattamente il settore nel quale amo affidarmi alla speranza.
Quando un’interfaccia web si rompe, generalmente la sistemi.
Quando un filesystem clusterizzato gestisce male una condizione di split-brain, potresti ritrovarti a spiegare a un cliente perché il suo database ha improvvisamente sviluppato una personalità multipla.
I problemi difficili non sono soltanto le prestazioni.
Sono i guasti.
Il nodo che si spegne durante una scrittura.
Il collegamento di rete che cade.
La SAN che smette temporaneamente di rispondere.
Il multipath che perde tutti i percorsi.
Il nodo isolato che torna online convinto di avere ancora il diritto di scrivere.
Il fencing che deve intervenire esattamente quando serve.
Per questo non basta vedere due macchine virtuali che migrano correttamente da un host all’altro.
Servono test distruttivi.
Servono benchmark.
Serve verificare il comportamento sotto carico.
Serve soprattutto qualcuno disposto a cercare i difetti, invece di limitarsi a celebrare le funzionalità.
Ed è proprio qui che una comunità open source può fare la differenza.
Il bello non è che esistano due progetti. È che domani potrebbero essercene dieci.
C’è una narrazione che ogni tanto torna fuori nel mondo IT.
Quella secondo cui la frammentazione dell’open source sarebbe necessariamente un problema.
Troppi progetti.
Troppe distribuzioni.
Troppi fork.
Troppi strumenti che fanno cose apparentemente simili.
E certamente la frammentazione può comportare costi di manutenzione, dispersione delle risorse e difficoltà di compatibilità.
Ma sapete quale sarebbe l’alternativa?
Un mondo nel quale esiste una sola implementazione possibile, decisa da un unico soggetto, e tutti gli altri devono adeguarsi.
Grazie, ma anche no.
La concorrenza tra idee è uno dei motori dell’innovazione.
Un progetto può scegliere un’architettura.
Un altro può sperimentarne una differente.
Un terzo può prendere il meglio di entrambi.
Uno può fallire.
Un altro può essere abbandonato.
Un altro ancora può diventare uno standard di fatto.
E talvolta una buona idea nata in un piccolo repository finisce per influenzare progetti molto più grandi.
Non è garantito che accada.
Ma la possibilità esiste.
Ed è questa possibilità a fare la differenza.
L’open source non è un supermercato del software gratis
Forse è proprio questo il concetto che vorrei lasciare a chi legge.
Troppo spesso ci avviciniamo all’open source con la mentalità del consumatore.
Cerchiamo un programma.
Lo installiamo.
Lo utilizziamo.
Se funziona, bene.
Se non funziona, ci lamentiamo.
Magari apriamo pure una issue scrivendo che è tutto rotto, senza allegare uno straccio di log.
Ma l’open source è molto più di un catalogo di prodotti gratuiti.
È un modello di sviluppo nel quale la conoscenza può circolare.
Nel quale un problema individuale può generare una soluzione collettiva.
Nel quale il lavoro di una persona può diventare il punto di partenza per quello di un’altra.
E nel quale persino due sconosciuti, che sviluppano indipendentemente due filesystem clusterizzati, possono incontrarsi su un forum e decidere di confrontare le proprie idee.
Senza chiedere autorizzazioni.
Senza firmare accordi di riservatezza.
Senza dover convincere qualcuno che il progetto genererà un ritorno economico nel prossimo trimestre.
Questo non significa che sviluppare software libero non costi nulla.
Il tempo, le competenze, i test e la manutenzione hanno un valore enorme.
Significa semplicemente che la possibilità di innovare non deve necessariamente dipendere dal permesso di chi controlla un prodotto.
E adesso?
Personalmente continuerò a seguire entrambi i progetti.
Non perché ritenga che domani sostituiranno Ceph, GFS2 o altre tecnologie consolidate.
E nemmeno perché sia convinto che rappresentino la soluzione definitiva allo storage condiviso di Proxmox.
Semplicemente perché sono interessanti.
Perché affrontano un problema reale.
Perché utilizzano approcci differenti.
E perché mi ricordano il motivo per cui, dopo tanti anni passati tra Linux, server, reti e infrastrutture, continuo a trovare questo mondo incredibilmente affascinante.
Probabilmente finiranno anche in qualche mio laboratorio.
Dove potrò fare quello che ogni sysadmin dovrebbe poter fare con una tecnologia sperimentale: installarla, stressarla, romperla, studiare perché si è rotta e magari contribuire a migliorarla.
Possibilmente senza coinvolgere i dati di produzione.
Che è sempre una buona abitudine.
Nel frattempo, una cosa è certa.
Il giorno in cui smetteremo di poter prendere un software, modificarlo e provare a costruire qualcosa di diverso, avremo perso una delle parti più importanti dell’informatica.
Non importa se MeshXFS e CetraFS diventeranno progetti maturi, se uno prevarrà sull’altro o se entrambi resteranno esperimenti di nicchia.
La loro esistenza dimostra che qualcuno può ancora guardare una tecnologia e dire:
«Bella. Ma secondo me possiamo fare qualcosa di diverso.»
E poi mettersi a farlo.
Senza aspettare il permesso di nessuno.
Questa, per me, è la vera spina dorsale dell’open source.
E francamente, dopo oltre trent’anni passati a smanettare con i computer, è ancora una delle cose che mi entusiasmano di più.
In Marvin We Trust.
Le opinioni in quanto tali sono opinabili e nulla ti vieta di approfondire l’argomento.
Risorse: