La tua immagine Docker pesa un giga
Immaginate un microservizio che deve fare una cosa relativamente semplice: ricevere una richiesta, verificare un’autenticazione e restituire una risposta.
Poi guardate l’immagine Docker.
Un giga e passa.
A quel punto una domanda dovrebbe sorgere spontanea: stiamo distribuendo il servizio oppure, per sicurezza, abbiamo incluso anche il computer dello sviluppatore, la scrivania e la stampante che non funziona dal 2019?
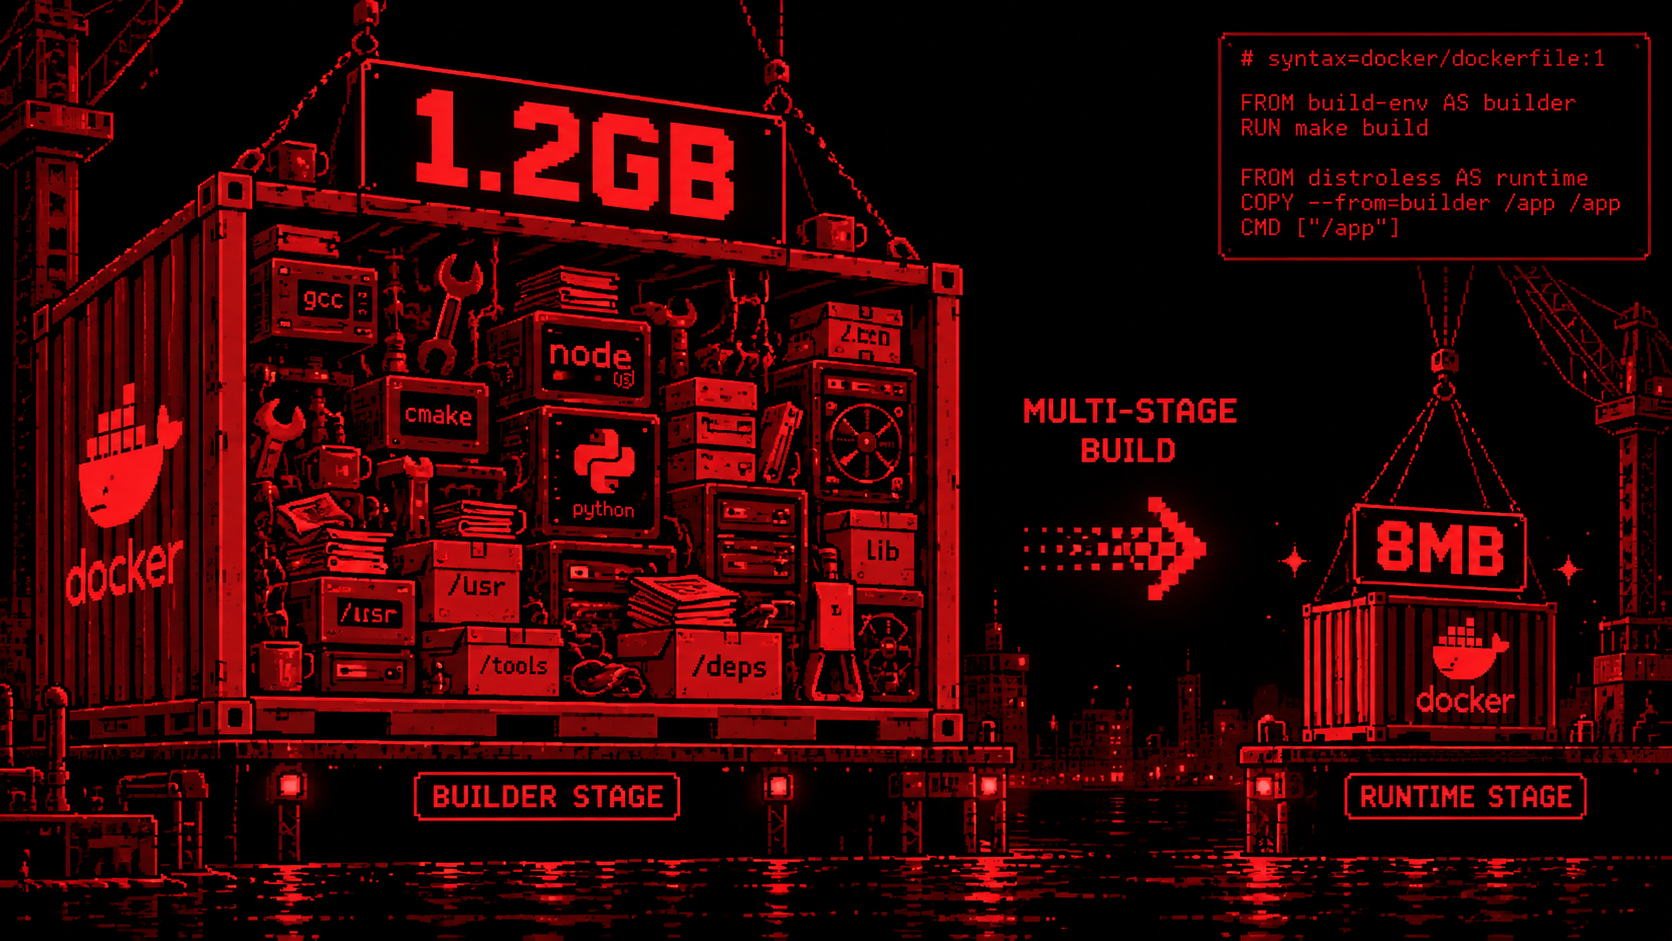
Lo spunto arriva da un articolo di The Thread Whisperer: l’autore racconta di aver ridotto l’immagine di un servizio di autenticazione da circa 1,2 GB a 8 MB, separando l’ambiente di compilazione da quello di esecuzione. Sono i numeri riportati nel suo caso, non un benchmark riprodotto qui e nemmeno una promessa valida per qualsiasi applicazione. Il principio, però, merita molta più attenzione del numero nel titolo.
Perché il punto non è fare a gara a chi ha l’immagine più piccola.
Il punto è capire che cosa stiamo mandando in produzione. E perché.
Funziona. Ma cosa ti stai portando dietro?
Prendiamo un Dockerfile di questo tipo, usando una versione disponibile dell’immagine ufficiale Go:
FROM golang:1.27.1-trixie

WORKDIR /app
COPY . .

RUN go build -o server .

CMD ["./server"]
È breve. È comprensibile. Compila l’applicazione e la avvia.
Il problema è che la base usata per compilare resta anche la base dell’immagine distribuita. Non abbiamo selezionato il necessario per l’esecuzione: abbiamo aggiunto il nostro programma a un ambiente di sviluppo e ci siamo portati dietro tutto il resto. È proprio la separazione che Docker raccomanda di introdurre quando strumenti di compilazione e dipendenze di sviluppo non servono in produzione.
È come consegnare un mobile lasciando in salotto anche il banco da lavoro, la sega circolare e tre scatoloni di materiale avanzato.
«Non si sa mai.»
Certo. Potremmo anche parcheggiare la betoniera in cucina.
La domanda utile non è «questa cosa occupa tanto?», ma:
Questo componente serve all’applicazione mentre gira, oppure è servito soltanto a costruirla?
Sembrano sfumature. Sono due responsabilità diverse.
Il disco costa poco. Il tempo sbagliato costa parecchio
La risposta classica è: «Ma tanto lo spazio costa poco».
Va bene. Per un momento dimentichiamoci del disco.
Immaginiamo invece un nodo nuovo, senza immagini in cache, che deve avviare rapidamente altre istanze del servizio. Prima di eseguire l’applicazione deve procurarsi i layer mancanti; i layer scaricati devono poi essere resi disponibili al filesystem del container. Trasportare materiale inutile significa aggiungere lavoro proprio in quel percorso.
La mia considerazione operativa è questa: durante un aumento improvviso del carico, avere capacità disponibile sulla carta non basta. Serve che diventi utilizzabile in tempo.
Il cliente che aspetta una risposta non si consola sapendo che il cluster ha un’architettura molto elegante.
Attenzione, però, a non trasformare un concetto corretto in uno slogan sbagliato: un’immagine più grande non viene necessariamente riscaricata interamente a ogni deploy. I layer possono essere già presenti. Anche in Kubernetes, imagePullPolicy: Always non significa «scarica sempre tutti i byte»: il runtime verifica l’immagine e può riutilizzare i layer locali.
Quindi il vantaggio dipende dal contesto: cache, nodi nuovi, layer modificati, registry e rete.
Non basta guardare una dimensione e inventarsi un miglioramento prestazionale.
Bisogna misurare il percorso che ci interessa davvero.
Multi-stage build: il cantiere non deve andare in produzione
Le multi-stage build permettono di usare più istruzioni FROM nello stesso Dockerfile. Ogni stadio può avere una base diversa; tra gli stadi copiamo soltanto gli artefatti necessari. Gli strumenti del primo ambiente non finiscono automaticamente nel secondo.
La divisione concettuale è semplice.
Nell’ambiente di build compiliamo, eseguiamo i test e produciamo l’applicazione. Nell’ambiente di runtime mettiamo il risultato e ciò che gli serve per funzionare.
Non è necessario rendere minuscolo il laboratorio per ottenere un prodotto leggero.
E questa, secondo me, è la parte interessante: non dobbiamo scegliere tra una build comoda e un runtime essenziale.
Possiamo avere entrambi.
A patto di smettere di considerarli la stessa cosa.
Mani in pasta: un Dockerfile meno improvvisato
Facciamo un esempio concreto per un servizio Go. Assumiamo che il progetto abbia il package main nella directory principale, i file go.mod e go.sum, e che possa funzionare senza dipendenze C obbligatorie. Per il successivo comando di avvio assumiamo anche che ascolti su :8080.
Il Dockerfile seguente aggiunge alla separazione degli stadi la gestione della cache e una prima esecuzione dei test:
# syntax=docker/dockerfile:1

ARG GO_VERSION=1.27.1

FROM golang:${GO_VERSION}-trixie AS build

WORKDIR /src

ENV CGO_ENABLED=0

# Prima le dipendenze: cambiano meno spesso del codice.
COPY go.mod go.sum ./

RUN --mount=type=cache,target=/go/pkg/mod \
    go mod download

# Poi il codice dell'applicazione.
COPY . .

RUN --mount=type=cache,target=/go/pkg/mod \
    --mount=type=cache,target=/root/.cache/go-build \
    go test ./... && \
    go build -trimpath -o /out/server .

FROM scratch AS runtime

# Necessari per la normale verifica delle CA nelle connessioni TLS.
COPY --from=build /etc/ssl/certs/ca-certificates.crt \
                  /etc/ssl/certs/ca-certificates.crt

COPY --from=build /out/server /server

USER 65532:65532

EXPOSE 8080

ENTRYPOINT ["/server"]
L’ordine delle copie evita di invalidare lo step di download delle dipendenze a ogni modifica del codice. I cache mount consentono inoltre a BuildKit di riutilizzare moduli e risultati della compilazione fra build successive. Quelle cache appartengono al processo di costruzione, non sono qualcosa che dobbiamo spedire nel runtime.
Lo stadio finale riceve il binario e il bundle delle CA, non l’intero contenuto di /src. L’applicazione viene configurata per partire con UID e GID non privilegiati, usando la forma exec di ENTRYPOINT, senza richiedere una shell.
Due precisazioni pratiche. Se il progetto usa soltanto la libreria standard e non ha go.sum, la prima copia diventa COPY go.mod ./. Se invece il programma principale è in ./cmd/server, sarà quel percorso a dover comparire nel comando go build.
E no: aver eseguito go test durante la compilazione non mi basta per promuovere questa immagine in produzione. Io voglio verificare anche il comportamento dell’immagine finale, con la configurazione e le dipendenze esterne che userà davvero.
Il Dockerfile non è un certificato di buona salute.
È il punto di partenza.
scratch non significa «Docker penserà al resto»
Qui arriva la parte che nei tutorial da trenta secondi tende a sparire.
scratch è un punto di partenza vuoto. Non offre automaticamente una distribuzione, un interprete, librerie dinamiche o un archivio di certificati. Docker sottolinea esplicitamente che le dipendenze di runtime devono essere considerate e fornite.
Quindi «copio il binario e funziona» è una possibilità.
Non una legge della fisica.
Il binario deve poter vivere in quell’ambiente
Nell’esempio abbiamo impostato:
ENV CGO_ENABLED=0
Questo disabilita cgo. Non converte magicamente qualsiasi progetto in un’applicazione priva di dipendenze native: i sorgenti che richiedono cgo vengono esclusi e un progetto che ne ha bisogno può non compilare, oppure selezionare implementazioni alternative quando disponibili. Va verificato sul software concreto.
La procedura corretta non è aggiungere una variabile e sperare fortissimo.
È capire le dipendenze, compilare e testare.
I certificati non sono arredamento
Un programma può avviarsi correttamente e fallire soltanto quando deve collegarsi a un servizio HTTPS. In un’immagine vuota, il materiale necessario a verificare le autorità di certificazione potrebbe non esserci: ecco perché nel Dockerfile abbiamo copiato il bundle delle CA. Eventuali CA aziendali richiedono una gestione aggiuntiva.
Togliere la verifica TLS perché «nel container piccolo non funziona» non è ottimizzazione.
È risolvere il problema della spia dell’olio con un pezzo di nastro isolante.
Anche fusi orari e file temporanei vanno considerati
Se l’applicazione utilizza zone come Europe/Rome, deve poter accedere ai relativi dati. In Go è possibile anche incorporarli attraverso time/tzdata o il build tag timetzdata.
Se deve scrivere file temporanei, dobbiamo prevedere un percorso scrivibile. Un filesystem in sola lettura può essere affiancato da mount dedicati, compreso un tmpfs, senza rendere scrivibile tutto il container.
Minimo indispensabile non significa meno dell’indispensabile.
Altrimenti non abbiamo ottimizzato un servizio. Abbiamo costruito un soprammobile molto leggero.
Non tutto deve finire in otto megabyte
L’esempio Go è utile perché rende evidente la distinzione tra compilatore e programma.
Ma non tutti gli stack hanno lo stesso modello di esecuzione.
Un’applicazione Java tradizionale continua ad avere bisogno del runtime Java. Un’applicazione Node.js del relativo runtime e delle dipendenze necessarie. Lo stesso ragionamento vale per Python. Il progetto Distroless, per esempio, distribuisce immagini distinte proprio per questi ambienti, oltre alle basi per binari statici.
Quindi la tecnica da generalizzare è la separazione delle responsabilità, non la dimensione finale del caso più favorevole.
scratch è una scelta quando siamo in grado di fornire esplicitamente tutto il necessario. Le immagini distroless offrono invece ambienti essenziali, normalmente senza shell, con varianti adatte a differenti runtime. Una base più tradizionale e ridotta può essere un compromesso sensato quando compatibilità e operatività lo richiedono. La raccomandazione di Docker è scegliere una base minima che soddisfi i requisiti, non una base minima a prescindere dai requisiti.
Anche «metto Alpine e ho risolto» merita qualche secondo di riflessione: Alpine usa musl invece di glibc, una differenza che può avere conseguenze sulla compatibilità. Non è soltanto la stessa scatola con meno megabyte.
Personalmente, preferisco un’immagine un po’ più grande che il team sa mantenere e diagnosticare a una minuscola che nessuno osa toccare.
L’ingegneria non assegna punti bonus per aver complicato la vita al collega di reperibilità.
La pulizia comincia prima del COPY
Una multi-stage build non rende automaticamente ragionevole questa istruzione:
COPY . .
Il punto è cosa c’è dentro quel punto.
Un .dockerignore permette di escludere dal contesto di build i file che non servono. Per un progetto potremmo partire da qualcosa del genere, adattandolo alla struttura reale:
.git
.env
.env.*
secrets/
*.key
tmp/
coverage/
dist/
Non è un sistema universale di rilevamento dei segreti. È una prima scelta esplicita su cosa il builder debba ricevere.
E quando alla build serve davvero una credenziale, per esempio per scaricare una dipendenza privata, la soluzione non è infilarla nel Dockerfile tramite ARG o ENV. Docker mette a disposizione secret mount e SSH mount proprio per fornire quel materiale durante le istruzioni che ne hanno bisogno.
Un altro equivoco riguarda la cancellazione: i layer sono immutabili. Rimuovere in uno step successivo un file introdotto in un layer precedente modifica la vista finale, ma non riscrive quel layer eliminandone i byte. Da qui l’importanza di non aggiungere materiale inutile, pulire nello stesso passaggio quando appropriato o lasciarlo in uno stadio che non verrà distribuito.
«Prima copio tutto, poi cancello» non è una strategia di sicurezza.
Soprattutto quando quel “tutto” comprende una chiave privata.
Più piccola non significa invulnerabile
Da consulente di sicurezza, qui tirerei il freno a mano.
Ridurre componenti e dipendenze superflue è una buona pratica. Riduce ciò che dobbiamo distribuire e mantenere e può ridurre la superficie d’attacco. Non sostituisce però la sicurezza dell’applicazione, l’isolamento del container o la corretta configurazione dei privilegi.
Un esempio logico, prima ancora che tecnico: se il servizio autorizza l’utente sbagliato a leggere un documento, togliere Bash dall’immagine non corregge quella decisione.
Abbiamo eliminato Bash.
Il documento continua ad andare alla persona sbagliata.
Anche le dipendenze dell’applicazione restano parte del problema. Per Go, govulncheck è uno degli strumenti ufficiali per individuare vulnerabilità note e valutare quali funzioni vulnerabili siano effettivamente utilizzate dal codice. L’assenza di pacchetti di distribuzione non ci autorizza a smettere di analizzare il programma.
All’immagine essenziale affiancherei quindi una configurazione di esecuzione altrettanto ragionata. Per provare localmente il servizio dell’esempio:
docker run --rm \
  --name server-demo \
  --read-only \
  --cap-drop=ALL \
  --security-opt=no-new-privileges=true \
  --tmpfs /tmp:rw,noexec,nosuid,nodev,size=16m,mode=1777 \
  -p 127.0.0.1:8080:8080 \
  server:runtime
Qui il filesystem principale è in sola lettura, le capability sono rimosse e viene impedita l’acquisizione di nuovi privilegi. /tmp resta scrivibile tramite un mount temporaneo, mentre la porta è pubblicata soltanto sul loopback dell’host. Sono opzioni documentate, da adattare ai requisiti dell’applicazione: i 16 MB di spazio temporaneo, per esempio, sono una scelta per questa prova, non una misura universale.
Non è «sicuro perché piccolo».
È più controllato perché abbiamo fatto scelte esplicite su contenuto ed esecuzione.
«E quando devo entrarci per capire cosa non va?»
Obiezione legittima.
In un’immagine senza shell, il consueto exec … sh non può funzionare. Kubernetes prevede i container effimeri di debug, utilizzabili attraverso kubectl debug, proprio anche per indagare workload privi degli strumenti diagnostici.
Ma la risposta organizzativa viene prima del comando.
Io voglio sapere come raccogliamo i log, quali metriche osserviamo, come distinguiamo un problema applicativo da uno di rete e quali accessi sono autorizzati durante un incidente.
Non mi convince né «mettiamo tutti gli strumenti in produzione, perché potrebbero servire», né «abbiamo tolto tutto, quindi adesso arrangiatevi».
La diagnostica va progettata.
Un’immagine essenziale con una procedura di troubleshooting inesistente non è una vittoria completa. Abbiamo soltanto spostato il problema alla prima notte complicata.
Misuriamo qualcosa di utile
Per osservare la differenza fra gli stadi del Dockerfile possiamo costruirli separatamente:
docker build --pull --target build -t server:build .
docker build --target runtime -t server:runtime .

docker image ls server
docker image history --no-trunc server:runtime
Docker permette di fermare la build a uno stadio specifico con –target; i comandi di elenco e history aiutano poi a osservare immagini e layer.
Il confronto mostra cosa abbiamo lasciato nel laboratorio e cosa abbiamo scelto di distribuire.
Non dimostra, da solo, quanto più rapidamente risponderà l’applicazione.
Per quello io misurerei l’avvio su un nodo senza cache e su uno già preparato, il tempo fino alla reale disponibilità del servizio e il comportamento sotto carico. Terrei distinti dimensione dell’immagine, traffico necessario al pull e risorse consumate dal processo: sono aspetti diversi, non numeri intercambiabili. Il riutilizzo dei layer e le modalità di conteggio delle dimensioni rendono particolarmente importante questa distinzione.
E dopo averla ridotta, l’immagine va mantenuta: aggiornare dipendenze e basi, ricostruire e verificare il risultato. Il pinning tramite digest identifica precisamente una base, ma richiede anche un processo per aggiornarla; non incorpora da solo le correzioni pubblicate successivamente.
Congelare qualcosa di piccolo e dimenticarsene rimane un modo molto ordinato di accumulare problemi.
Il vero obiettivo non è dimagrire. È sapere cosa stai distribuendo
Non mi interessa premiare automaticamente un’immagine da 8 MB o bocciarne una da 300.
Mi interessa che qualcuno sappia spiegarmi perché quei componenti sono lì.
Che sappia distinguere ciò che serve a costruire da ciò che serve a eseguire. Che abbia verificato il comportamento finale. Che sappia aggiornare il servizio e capire cosa succede quando smette di funzionare.
La multi-stage build è uno strumento semplice per rendere esplicita questa distinzione.
Non serve trasformarla in una religione. Serve usarla con criterio.
Perché «tanto funziona» descrive un momento.
«So cosa contiene, perché lo contiene e come lo gestisco» descrive un sistema.
Il compilatore serve in cantiere. In produzione, possibilmente, consegniamo il lavoro finito.
Le opinioni in quanto tali sono opinabili e nulla ti vieta di approfondire l’argomento.
Risorse: